基础
数据类型
在python中,数字型数据包括以下几种:
1.整型(int):正整数、负整数和0
2.浮点型(float):浮点数也就是小数,因为浮点数也可能表示为科学计数法(如 1.23e9,或者 12.3e8),所以,浮点数运算结果也可能有误差
3.布尔型(bool):特殊的整型,只有True和False,True为1,False为0
在python中,可以直接用 True、False 表示布尔值(请注意大小写),也可以通过布尔运算计算出来:
and运算是与运算,只有所有都为True,and运算结果才是Trueor运算是或运算,只要其中有一个为True,or运算结果就是Truenot运算是非运算,它是一个单目运算符,把True变成False,False变成True
4.空值:空值是 Python 里一个特殊的值,用 None 表示。None 不能理解为 0,因为 0 是有意义的,而 None 是一个特殊的空值
5.复数(complex):分为实部和虚部,复数可以用多种方式表示,例如"a+bi"表示,其中a是实部,b是虚部,i是虚数单位
字符串
字符串:字符串是以单引号'或双引号"括起来的任意文本,比如'abc',"xyz"等等。字符串还有一些特殊字符,可以通过转义字符\来表示,比如:
- \n 表示换行
- \t 表示制表符,相当于Tab
- \\表示反斜杠本身
- \r 将光标移至当前行的开头
- \ 表示后面转义本身,'和"
- \U 表示 Unicode 编码
- \x 表示十六进制数
- \0 表示八进制数
引号不能混合使用,且引号只是字符串的一个表达方式,本身不属于字符串内容
Unicode是一种字符编码标准,旨在为世界上所有的字符(包括文字、符号、表情等)分配一个唯一的数字编号,解决传统编码(如英文用ASCII,中文用GB2312等)导致跨语言文本容易出现乱码
访问与操作
通过下标访问和切片访问
下标访问:所谓下标,其实就是编号,可以从左往右编号 [0,1,2...] 也可以按照从右往左 [-1,-2...],访问下标不可以超出范围。
切片访问:切片访问与下标访问类似,都是通过字符串的下标进行的,不同的是,下标访问每次只能访问到单个字符,切片访问可以一次访问到多个字符,其访问方式为:
字符串名[初始位置:终止位置:步长]
访问时,包括初始位置不包括终止位置,且步长默认为 1。如果没有给出初始位置,默认初始位置为开始位置;如果没有给出终止位置,默认终止位置为字符串结束位置,此时访问时包括终止位置。
字符串的比较
字符串的比较是逐个字符比较,从字符串的第一个字符开始比较,如果两个字符的 Unicode编码值相同,则继续比较下一个字符,直到所有字符都比较完毕。
字符串的"加法"和"乘法"
在Python中,使用加号(+)可以将两个字符串拼接起来,并返回一个新的拼接好的字符串。
使用乘号(*)乘以一个整数n,可以将某个字符串复制n次,并返回一个新的复制n次的字符串。
列表
列表:是一种有序的元素集合,用于存储一组有序的数据,可以包含任意数量的元素,并且每个元素可以是不同的数据类型。与字符串不同的是,列表的元素是可以修改的。
列表使用方括号 [] 来表示,其定义方式为:
列表名称 = [元素 1, 元素 2, ..., 元素 n]
列表的访问
列表的访问:下标访问和切片访问。
下标访问:与字符串的索引一样,列表索引从左到右从0开始,从右到左从-1开始。注意访问时不能超出下标范围,其访问方式为:
列表名[下标]
切片访问:与下标访问一样的是都是使用下标来访问,不同的是切片访问可以一次访问多个元素,其访问方式为:
列表名字[初始位置: 终止位置: 步长]
访问时,包括初始位置不包括终止位置,且步长默认为1。如果没有给出初始位置,默认初始位置为开始位置;如果没有给出终止位置,默认终止位置为列表结束位置,此时访问时包括终止位置。
列表元素的增加
| 函数 | 描述 |
|---|---|
append() | 向列表的尾部添加元素 |
insert() | 向列表的指定位置添加元素 |
extend() | 将另一个列表的所有元素添加到本列表的后面 |
列表元素的删除
| 函数 | 描述 |
|---|---|
remove() | 删除指定的元素 |
pop() | 用于移除列表的一个元素,可以指定下标,并将其元素返回。 |
clear() | 删除列表中的所有元素 |
del | 指定下标时删除对应的元素,不指定时删除整个列表对象。 |
列表元素的修改
使用下标或切片的方式对列表中的单个元素或多个元素进行修改。
列表名[索引] = 新的元素内容
list_name[0] = 'lisi'
list_name[0:2] = ['zhangsan', 'lisi']
列表元素的查找
所谓的查找,就是查看某元素是否存在于该列表里,这里有三个方法:
count():返回列表中某个元素的数量- 使用
in关键字查找,如果存在就返回True,否则返回False - 使用
not in关键字查找,如果不存在就返回True,否则返回False
列表的其他常用操作:
len():获取列表中元素的个数reverse():反转列表中的元素sort():对列表元素进行排序copy():对列表的拷贝
列表推导式
列表推导式:是一种简洁的方式来创建或修改列表的方法,它允许你使用单行的代码从一个已有的可迭代对象(如列表、元组、集合、字典等)中快速构建新的列表,其语法如下:
new_list = [expression for item in iterable if condition]
expression是对item的操作或表达式,用于生成新的列表元素。item是可迭代对象中的元素,例如列表中的元素。iterable是用于迭代的可迭代对象,例如列表、元组、集合等。condition是一个可选的条件,用于过滤元素。
例如:
list = [x**2 for x in range(5)]
print(list)  # 输出: [0, 1, 4, 9, 16]
列表vs字符串
列表是可变的
a = [1, 2, 3, 4]
a[0] = 100
a.insert(3, 200)
a  # [100, 2, 3, 200, 4]
字符串是不可变的
s = "hello world"
# 通过索引改变会报错
s[0] = 'k'
字符串方法只是返回一个新字符串,并不改变原来的值:
print(s.replace('world', 'Mars'))  # hello Mars
print(s)  # hello world

# 如果想改变字符串的值,可以用重新赋值的方法:
s = s.replace('world', 'YunYun')
print(s)  # hello YunYun
深拷贝与浅拷贝
python 中变量是引用,也就是指针,不是值本身:
a = [1, 2, 3]
b = a

b.append(4)
print(a) # [1, 2, 3, 4],这里发现a变了,因为是同一个对象
这不是拷贝,这是别名,拷贝是为了打破这种绑定。
浅拷贝
创建新的外层容器,但元素仍然共享引用。
import copy

original = [{"name": "Alice"}, {"name": "Bob"}]

# 三种等价写法
shallow = list(original)
shallow = original.copy()
shallow = copy.copy(original)

"""
内存结构:

original ──→ [列表对象 A]
                ├── [0] ──→ {"name": "Alice"}  ←── 共享!
                └── [1] ──→ {"name": "Bob"}    ←── 共享!

shallow  ──→ [列表对象 B](新的)
                ├── [0] ──→ {"name": "Alice"}  ←── 同一个 dict
                └── [1] ──→ {"name": "Bob"}    ←── 同一个 dict
"""

# 列表结构操作 → 互不影响
shallow.append({"name": "Charlie"})
len(original)  # 2 ← 没变
len(shallow)   # 3

# 修改共享元素 → 互相影响
shallow[0]["name"] = "MODIFIED"
original[0]["name"]  # "MODIFIED" ← 被改了!
深拷贝
递归复制所有层级,完全独立。
import copy

original = [{"name": "Alice"}, {"name": "Bob"}]
deep = copy.deepcopy(original)

"""
内存结构:

original ──→ [列表对象 A]
                ├── [0] ──→ {"name": "Alice"}   ← 对象 X
                └── [1] ──→ {"name": "Bob"}     ← 对象 Y

deep     ──→ [列表对象 B](新的)
                ├── [0] ──→ {"name": "Alice"}   ← 对象 X'(新的,内容相同)
                └── [1] ──→ {"name": "Bob"}     ← 对象 Y'(新的,内容相同)

完全隔离:

deep[0]["name"] = "MODIFIED"
original[0]["name"]  # "Alice" ← 不受影响
"""

# 嵌套越深,差异越明显
original = [[1, 2], [3, 4]]

shallow = copy.copy(original) # 浅拷贝
shallow[0].append(999)
original  # [[1, 2, 999], [3, 4]] ← 被污染了

deep = copy.deepcopy(original)
deep[0].append(888)
original  # [[1, 2, 999], [3, 4]] ← 不受影响
总结
| 操作 | 赋值 b = a | 浅拷贝 | 深拷贝 |
|---|---|---|---|
| 新建外层容器 | 否 | 是 | 是 |
| 递归复制内层元素 | 否 | 否 | 是 |
append/remove 互相影响 | 是 | 否 | 否 |
| 修改嵌套元素互相影响 | 是 | 是 | 否 |
| 性能开销 | 零 | 低 | 高 |
元组
元组与列表非常的相似,不同之处在于元组的元素不可修改。
元组使用圆括号()来表示,其定义方式为:
元组名字 = (元素1, 元素2, ..., 元素n)
序列
序列(Sequence)是一个抽象概念,它指的是可以按照索引位置访问元素的有序数据结构。标准序列类型包括列表(list)、元组(tuple)和字符串(str),其中列表叫做可变序列,元组和字符串叫做不可变序列。
集合
集合是一个无序的不重复元素序列,分为可变集合与不可变集合。可变集合的元素在定义好之后是不可修改的,但集合本身是可以增加、删除元素的,这意味着集合的元素只能是数字、字符串及元组,并且每个元素在集合中只会出现一次。
集合使用花括号{}表示,集合的创建方法为:
集合名称 = {元素1, 元素2, ..., 元素n}
集合在python3.7及以后的版本变成有序的了,但这个有序仅仅只是因为底层的存储方式改变而造成的"偶然"的有序性,并不能作为我们的依赖。
字典
字典也是一种无序的数据类型,与其他的数据类型不同的是,字典的数据是以键值对的方式进行存储的,键值对是可以进行修改的。
字典也用花括号{}表示,与集合的区别就是花括号{}里的内容以键值对的形式存在,其定义如下:
字典名 = {键1: 值1, 键2: 值2, 键3: 值3, ……}
字典在python3.7及以后的版本变成有序的了,但为了程序的兼容性,建议在写程序时不要利用这个字典的顺序。
键值对的特性
一个字典中,键是唯一的,且键和值是一一对应的,如果定义了相同的键,那么新定义的值会覆盖原值。
键必须不可变,可以用数字、字符串或元组,但不能用列表,值可以是任何数据类型。
字典的访问
只能通过唯一的键来访问对应的值,其访问方式为:
字典名[键名]
通过这种方法就可以得到该键所对应的值,如果字典中没有这个键就会报错。
字典推导式
{键表达式: 值表达式 for 变量 in 可迭代对象 if 条件}
- 键表达式:生成字典键的表达式。
- 值表达式:生成字典值的表达式。
for 变量 in 可迭代对象:遍历可迭代对象中的每个元素。if 条件(可选):过滤元素的条件,满足条件的元素才会被包含在新字典中。
举个简单例子:
squares = {x: x**2 for x in range(1, 6)}
print(squares)  # 输出: {1: 1, 2: 4, 3: 9, 4: 16, 5: 25}
装饰器
在 Python 中,装饰器(Decorator)本质上是一种特殊的嵌套函数,它接收一个函数作为参数(该函数就是被装饰的函数),并返回一个新的函数(装饰之后的函数)。
装饰器最大的作用就是可以让我们在不改变被装饰函数的代码的情况下去给它添加新的功能。
本质上装饰器就是返回一个函数的高阶函数
装饰器是在不修改目标函数(或类)代码的前提下,为目标函数(类)新增功能的函数(类)
使用场景:性能测试、打印日志等
import time

def timer(func):
    def wrapper(*args,**kwargs):
        start_time = time.time()
        func(*args,**kwargs)
        end_time = time.time()
        print(f"花费时间: {end_time - start_time} seconds")
    return wrapper

@timer
def func1():
    print("我是一个函数1")

@timer
def func2():
    print("我是一个函数2")

# @timer
def func3():
    print("我是func3,我是一个没有装饰器的函数")

if __name__ == "__main__":
    func1()
    func2()
    func3()
闭包函数
嵌套函数:在一个函数的内部还定义了另一个函数,这个函数就叫嵌套函数。外部的我们叫它外函数,内部的我们叫他内函数。
闭包函数:如果内函数使用了外函数的局部变量,并且外函数把内函数返回出来的过程叫做闭包,里面的内函数是闭包函数。
def nth_power(exponent):
    def exponent_of(base):
        return base ** exponent
    return exponent_of

square = nth_power(2)
cube = nth_power(3)

print(square(2))
print(cube(2))
单例模式
单例模式就是保证某个类在系统里只有一个实例,并提供一个全局的访问点。比如我们经常会用它来做配置管理、数据库连接池、日志记录器。
它的好处是可以避免重复创建、节省资源,并且全局数据一致。不过也要注意,单例如果乱用,会导致代码耦合太高,不容易测试。
举个简单的例子
class Singleton:
    _instance = None# 类属性,用来存放这个类唯一的实例对象,一开始设为 None,表示还没创建过

    def __new__(cls, *args, **kwargs):# __new__ 是用来创建对象(分配内存),并返回这个新对象的
        if cls._instance is None:# 判断 _instance 是否为空。如果还没有创建过实例,就需要创建。
            cls._instance = super().__new__(cls)
        return cls._instance

# 测试
a = Singleton()
b = Singleton()

print(a is b)  # True,说明它们是同一个对象
生成器
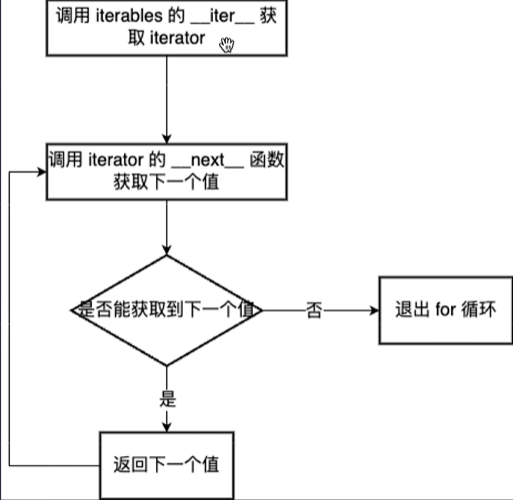
从可迭代对象中获取迭代器
* 和 ** 解包运算符
Python 中 * 和 ** 在函数定义和函数调用中各有不同的含义,但核心思想一致:* 处理位置参数(元组),** 处理关键字参数(字典)。
1.函数定义中:收集参数
*args:收集多余的位置参数,打包成元组**kwargs:收集多余的关键字参数,打包成字典
def func(a, b, *args, **kwargs):
    print(f"a={a}, b={b}")
    print(f"args={args}")
    print(f"kwargs={kwargs}")

func(1, 2, 3, 4, x=10, y=20)
# a=1, b=2
# args=(3, 4)
# kwargs={'x': 10, 'y': 20}
参数顺序必须是:普通参数 → *args → **kwargs。
2.函数调用中:解包参数
定义时是「收集打包」,调用时正好相反——是「拆开解包」。
* 和 ** 解包示例
def introduce(name, age, city):
    print(f"{name}, {age}岁, 来自{city}")

args = ["Alice", 25, "北京"]
introduce(*args)          # 等价于 introduce("Alice", 25, "北京")

kwargs = {"name": "Bob", "age": 30, "city": "上海"}
introduce(**kwargs)       # 等价于 introduce(name="Bob", age=30, city="上海")
** 只能解包字典,键必须是字符串且要和函数参数名一一对应。* 可以解包任何可迭代对象,列表、元组、range、字符串、生成器等。