向量的基础概念
什么是向量
RAG流程中,向量库是一个重要的节点。
- 离线流程:知识和信息 → 向量嵌入(向量化) → 存入向量库
- 在线流程:用户的提问 → 向量嵌入(向量化) → 在向量库中匹配
向量(Vector)就是文本的 "数学身份证":它把一段文字的语义信息,转换成一串固定长度的数字列表,让计算机能 "看懂" 文字的含义并做相似度计算。
简单来说,就是让计算机更方便的理解不同的文本内容,是否表述的是一个意思。
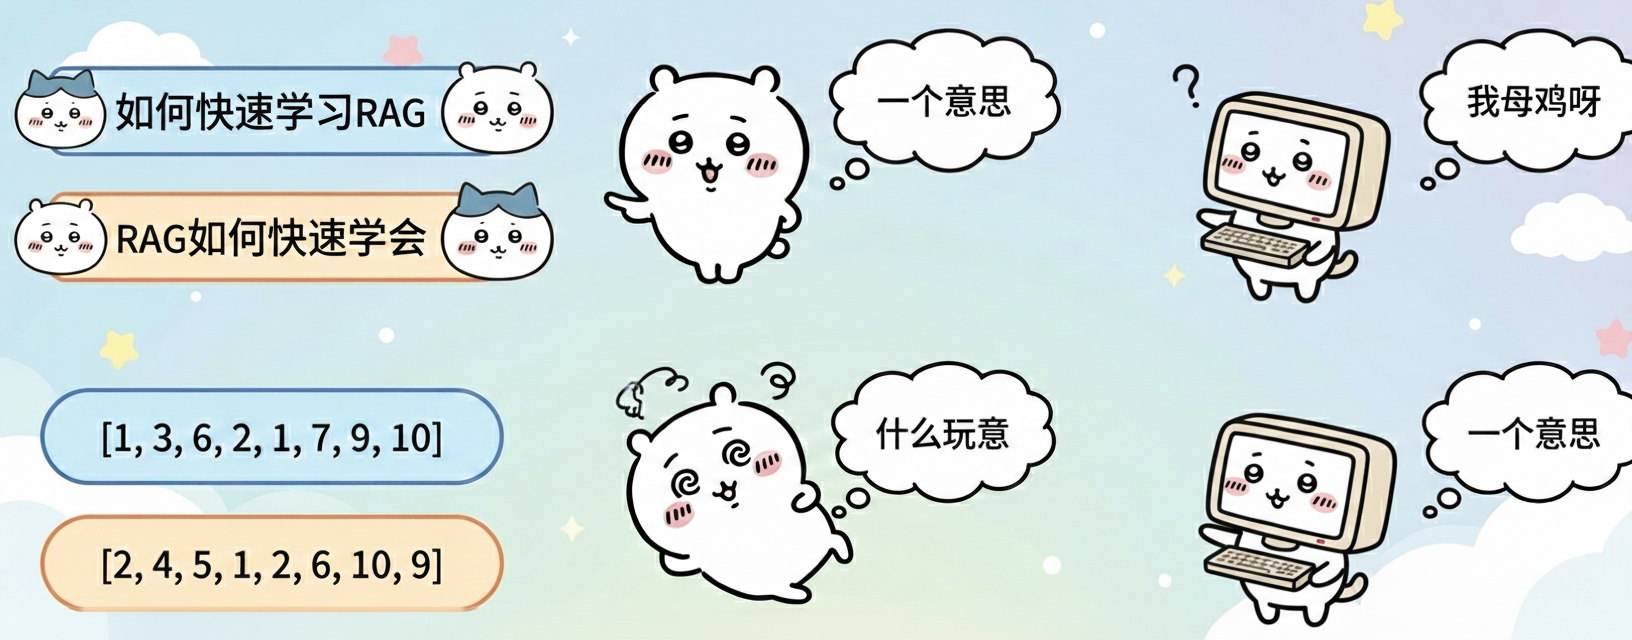
文本嵌入模型
文本嵌入模型(如 text-embedding-v1)通过深度学习等技术,从文本提取语义特征并映射为固定长度的数字序列。
向量嵌入的过程,我们一般选用合适的文本嵌入模型来完成。
向量相似度计算
在向量匹配的过程中,如何识别 2 段文本是否表述相似的含义,主要可以通过如余弦相似度等算法来完成。
比如(下列案例中向量为示例,仅描述概念,非真实向量):
- A:"如何快速学打篮球" → [0.2, 0.5, 0.8]
- B:"打篮球怎么学得快" → [0.18, 0.52, 0.79]
- C:"运动后吃什么好呢" → [0.9, 0.1, 0.2]
通过余弦相似度算法可以计算得到:A 和 B 相似度 0.999789,A 和 C 相似度 0.361446
由此可通过精确的数学计算,去匹配 2 段文本是否描述同一个意思,提高语义匹配的效率和精度。
向量维度
如何更为精准的完成语义匹配,生成向量的维度是一个很重要的指标。
如 text-embedding-v1 模型,可以生成1536维的向量(一段文本固定得到1536个数字序列),比较实用。
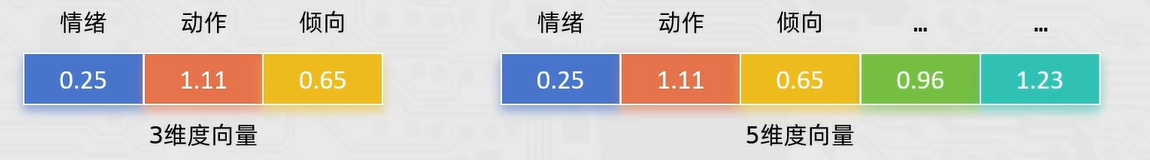
维度的含义
- 1536个数字表示,这段文本在1536个主题(抽象的语义特征)方向上的得分(强度)
- 生成向量的维度越多,就更好的记录文本的语义特征,做语义匹配会更加精准。
- 更多的向量会在计算、存储和匹配过程中,带来更大的压力。
维度与性能的权衡
选择合适的向量维度需要在精确和性能之间做平衡。一般1536维算是比较好的选择。
总结
1.向量的计算(文本嵌入过程),可借助文本嵌入模型实现,如text-embedding-v1
2.向量的匹配通过算法实现,如余弦相似度
3.向量的维度表示一段文本在多个抽象语义特征方面的强度
- 维度数代表模型用多少个抽象语义特征来描述文本
- 维度越多,做语义匹配越精准
- 但性能压力也会增大