VectorStores向量存储
介绍
基于LangChain的向量存储,存储嵌入数据,并执行相似性搜索。
如图,这是一个典型的向量存储应用,也即是典型的RAG流程。
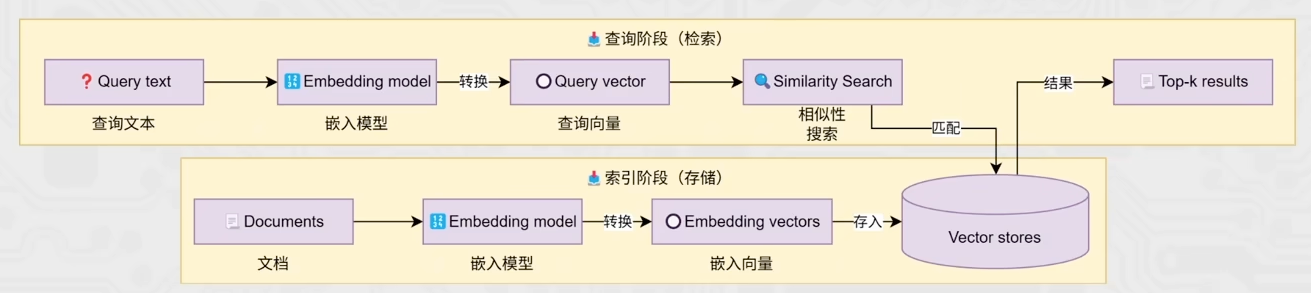
这部分开发主要涉及到:
- 如何文本转向量(前文已经学习)
- 创建向量存储,基于向量存储完成:
- 存入向量
- 删除向量
- 向量检索
LangChain为向量存储提供了统一接口:
add_documentsdeletesimilarity_search
内置向量存储的使用
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings

vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings())
# 添加文档到向量存储,并指定id
vector_store.add_documents(documents=[doc1, doc2], ids=["id1", "id2"])
# 删除文档(通过指定的id删除)
vector_store.delete(ids=["id1"])
# 相似性搜索
similar_docs = vector_store.similarity_search("your query here", 4)
外部(Chroma)向量存储的使用
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_chroma import Chroma

vector_store = Chroma(
    collection_name="example_collection",
    embedding_function=DashScopeEmbeddings(),
    persist_directory="./chroma_langchain_db",  # Where to save data locally, remove if not necessary
)
代码实践
内存存储
在data目录下准备csv示例数据stud.csv
name,age,gender,hobby
王梓涵,25,男,"吃饭,rap"
刘若曦,22,女,"睡觉,rap"
陈俊宇,20,男,"吃饭,rap"
赵思瑶,28,女,"睡觉,rap"
黄浩然,15,男,"吃饭,rap"
林雨桐,20,女,"唱跳,rap"
周博文,20,男,"吃饭,rap"
吴诗琪,24,女,"吃饭,rap"
马子轩,22,男,"睡觉,rap"
孙悦然,27,女,"吃饭,rap"
import os

from dashscope import api_key
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader
from dotenv import load_dotenv

load_dotenv()
api_key = os.getenv("LLM_API_KEY")

vector_store = InMemoryVectorStore(
    embedding=DashScopeEmbeddings(dashscope_api_key=api_key)
)

loader = CSVLoader(
    file_path="./data/stud.csv",
    encoding="utf-8",
    source_column="name",  # 指定本条数据的来源是哪里
    csv_args={
        "quotechar":'"',
    }
)

documents = loader.load()
# print(documents[1])

# id1 id2 id3 id4 ...
# 向量存储的 新增、删除、检索
vector_store.add_documents(
    documents=documents,      # 被添加的文档,类型:list[Document]
    ids=["id"+str(i) for i in range(1, len(documents)+1)]  # 给添加的文档提供id(字符串) list[str]
)

# 删除   传入[id, id...]
vector_store.delete(["id1", "id2"])

# 检索 返回类型list[Document]
result = vector_store.similarity_search(
    query="林雨桐",
    k=3        # 检索的结果要几个
)

print(result)
外部向量数据库
iimport os

from langchain_chroma import Chroma
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader
from dotenv import load_dotenv
# Chroma 向量数据库(轻量级的)
# 确保 langchain-chroma chromadb 这两个库安装了的,没有的话请pip install

load_dotenv()
api_key = os.getenv("LLM_API_KEY")

vector_store = Chroma(
    collection_name="test",         # 当前向量存储起个名字,类似数据库的表名称
    embedding_function=DashScopeEmbeddings(dashscope_api_key=api_key), # 嵌入模型
    persist_directory="./chroma_db" # 指定数据存放的文件夹
)

loader = CSVLoader(
    file_path="./data/stud.csv",
    encoding="utf-8",
    source_column="name",  # 指定本条数据的来源是哪里
    csv_args={
        "quotechar":'"',
    }
)

documents = loader.load()
# print(documents[1])

# id1 id2 id3 id4 ...
# 向量存储的 新增、删除、检索
vector_store.add_documents(
    documents=documents,      # 被添加的文档,类型:list[Document]
    ids=["id"+str(i) for i in range(1, len(documents)+1)]  # 给添加的文档提供id(字符串) list[str]
)

# 删除   传入[id, id...]
vector_store.delete(["id1", "id2"])

# 检索 返回类型list[Document]
result = vector_store.similarity_search(
    query="吃饭",
    k=3,        # 检索的结果要几个
    filter={"source": "吴诗琪"}
)

print(result)
总结
LangChain内提供向量存储功能,可以基于:
InMemoryVectorStore,完成内存向量存储Chroma,外部数据库向量存储
向量存储类均提供3个通用API接口:
add_document,添加文档到向量存储delete,从向量存储中删除文档similarity_search:相似度搜索