阿里天池二手车价格预测比赛Top2分享
这是关于我在比赛中如何一步步提升分数,最终取得第2名成绩方案的心得分享
前言
在初步掌握经典神经网络的基本原理之后,导师向我推荐了阿里云的天池比赛,我怀着检验自己学习成果的心态,开始了这次比赛的征程。最后也是取得了第二名,虽然遗憾失去天猫精灵(第一名奖品),但是我也从这次比赛学到了很多东西,通过比赛我感觉到自己成长了不少,话不多说,先上图。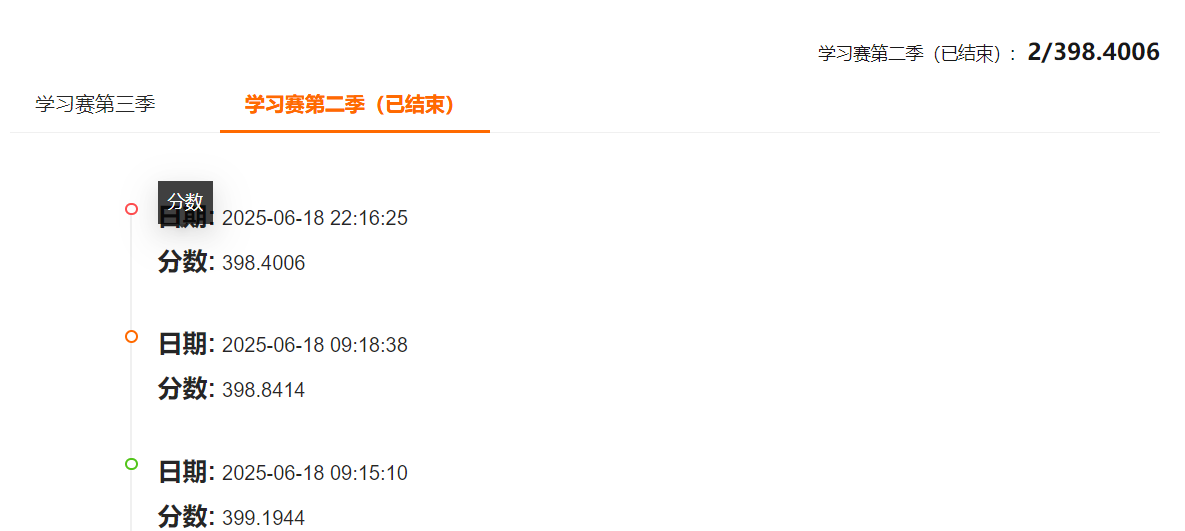
初始阶段
- 迷茫与起步:刚开始接触赛题时,我也和其他参赛者一样感到困惑,不知从何入手。于是,我决定按照天池提供的基准线(baseline)来运行基础模型,看看能获得多少分数。
- 挑战与解决:然而,运行基准线模型的过程并不顺利,训练时间异常漫长。尽管我使用的是性能不错的4060显卡,本地训练速度仍然缓慢。最终,通过算力平台的帮助,我成功跑通了模型,但得分仅为700左右。
提升分数
- 初步目标:最初,我设定的目标是超越官方基准线的分数。然而,当我看到排行榜上的高分时,心中燃起了不服输的斗志。
- 资料查阅:为了提升分数,我开始广泛查阅资料,包括CSDN和阿里论坛,希望能从前辈的经验中找到提升模型性能的方法。
学习与实践
- 学习路线:在拥有基础模型后,我尝试应用所学的提升模型性能的方法,如控制变量法进行调优,并将网络结构更换为ResNet。然而,效果并不理想,有时甚至出现上千分的异常情况。
- 前辈经验:在导师的推荐下,我观看了B站上的顶级方案分享视频,从中了解到特征工程的重要性。我花费数日时间深入学习,并结合自身理解进行优化。
特征工程
- 重要性认识:通过学习,我认识到数据预处理和特征工程才是决定模型上限的关键因素,而网络调优只是锦上添花。
- 实践效果:将重点转向特征工程后,即使使用简单的全连接神经网络,效果也显著提升,分数大幅上升,使我跃居排行榜前列。
模型融合
- 理论应用:受到随机森林论文的启发,我决定尝试模型融合,即通过组合多个弱模型来构建强模型。
- 具体操作:经过与树模型的加权融合,我的分数进一步提升至406。随后,通过凯明初始化参数和添加新的相关性特征交互,分数稳定在398。
以下是模型的详细介绍
1. 特征工程
特征工程是机器学习流程中至关重要的一步,它通过从原始数据中提取、转换和创建新特征,以提高模型的预测能力。
1.1 数据加载与合并
首先,加载了训练集和测试集数据,并将它们合并以便统一处理。
# 路径设置
input_path = '''./datasets/'''
output_path = '''./prediction_result/'''
user_data_path = '''./user_data/'''
os.makedirs(output_path, exist_ok=True)
os.makedirs(user_data_path, exist_ok=True)

# 读取数据
Train_data = pd.read_csv(input_path+'''used_car_train_20200313.csv''', sep=''' ''')
Test_data = pd.read_csv(input_path+'''used_car_testB_20200421.csv''', sep=''' ''')

# 合并数据方便处理
df = pd.concat([Train_data, Test_data], ignore_index=True)
1.2 异常数据处理
对数据中的异常值进行修正,包括:
- 删除
seller为1的异常记录。 - 将
power大于600的值截断为600。 - 将
v_14大于4的值修正为4。
# 处理异常数据
df.drop(df[df['''seller'''] == 1].index, inplace=True)
df_copy = df.copy()
# 只对power>600的值进行截断处理
df['''power'''][df['''power''']>600]=600

# 处理v_14异常值
v14_outliers = (df['''v_14'''] > 4).sum()
if v14_outliers > 0:
    print(f"    修正 {v14_outliers} 条v_14>4的异常值")
    df['''v_14'''][df['''v_14'''] > 4] = 4
1.3 notRepairedDamage 特征处理
将 notRepairedDamage 列中的 '-' 替换为 0.5,然后进行标签编码。
# notRepairedDamage处理
df.replace(to_replace = '''-''', value = 0.5, inplace = True)
le = LabelEncoder()
df['''notRepairedDamage'''] = le.fit_transform(df['''notRepairedDamage'''].astype(str))
1.4 日期特征工程
从 regDate (注册日期) 和 creatDate (创建日期/交易日期) 中提取年、月、日信息,并计算:
car_age_day(车龄天数)car_age_year(车龄年数)used_time_month(使用月数)is_weekend(交易日期是否为周末)depreciation_year(基于车龄的折旧率,一个自定义函数)
# 日期处理
from datetime import datetime
def date_process(x):
    year = int(str(x)[:4])
    month = int(str(x)[4:6])
    day = int(str(x)[6:8])
    if month < 1:
        month = 1
    date = datetime(year, month, day)
    return date

df['''regDates'''] = df['''regDate'''].apply(date_process)
df['''creatDates'''] = df['''creatDate'''].apply(date_process)
df['''regDate_year'''] = df['''regDates'''].dt.year
df['''regDate_month'''] = df['''regDates'''].dt.month
df['''regDate_day'''] = df['''regDates'''].dt.day
df['''creatDate_year'''] = df['''creatDates'''].dt.year
df['''creatDate_month'''] = df['''creatDates'''].dt.month
df['''creatDate_day'''] = df['''creatDates'''].dt.day
df['''car_age_day'''] = (df['''creatDates'''] - df['''regDates''']).dt.days
df['''car_age_year'''] = round(df['''car_age_day'''] / 365, 1)
# 新增特征:月数计算
df['''used_time_month'''] = round(df['''car_age_day'''] / 30, 3)
# 新增特征:交易日期是否为周末
df['''is_weekend'''] = df['''creatDates'''].dt.dayofweek.apply(lambda x: 1 if x in(5,6) else 0)
# 新增特征:使用年限折旧率
def depreciation_year(year):
    if year <= 3:
        return 1 - year * 0.15
    elif year > 3 and year <= 7:
        return 0.55 - (year-3) * 0.1
    elif year > 7 and year <= 10:
        return 0.25 - (year-7) * 0.05
    else:
        return 0
df['''depreciation_year'''] = df['''car_age_year'''].apply(lambda x: depreciation_year(x))
1.5 name_count 特征
计算每个 name (车辆名称) 出现的次数,这可以作为衡量该名称热门程度的特征。
# name_count特征
df['''name_count'''] = df.groupby(['''name'''])['''SaleID'''].transform('''count''')
1.6 缺失值填充
使用众数填充除特定列外所有特征的缺失值。
# 用众数填充缺失值
for col in df.columns:
    if col in ['''SaleID''', '''name''', '''regDate''', '''creatDate''', '''price''',
                                                        '''seller''', '''offerType''', '''train''', '''regDates''', '''creatDates''']:
        continue
    if df[col].dtype == '''object''' or df[col].dtype == '''int64''' or df[col].dtype == '''float64''':
        mode_val = df[col].mode()[0]
        df[col].fillna(mode_val, inplace=True)
1.7 城市信息与年平均里程
- 从
regionCode(邮编) 中提取city(城市) 信息。 - 计算
kilometer_everyear(年平均里程)。
# 新增特征: 从邮编提取城市信息
df['''city'''] = df['''regionCode'''].apply(lambda x: str(x)[:-3])
df['''city'''].replace(''''''', '''0''', inplace=True)
# 计算年平均里程
df['''kilometer_everyear'''] = round(1000 * df['''kilometer'''] / df['''car_age_year'''].clip(lower=0.1), 3)
df['''kilometer_everyear'''].fillna(df['''kilometer_everyear'''].median(), inplace=True)
# ... existing code ...
1.8 计数编码特征 (Count Features)
对多个类别特征(model, brand, bodyType, fuelType, gearbox, regDate_year)进行计数编码,即计算每个类别值的出现次数。
# 新增特征: 计数特征(热门程度)
def count_features(df, feat_cols):
    for feat in tqdm(feat_cols, desc="计数编码"):
        df[feat + '''_count'''] = df[feat].map(df[feat].value_counts())
    return df
count_feature_list = ['''model''', '''brand''', '''bodyType''', '''fuelType''', '''gearbox''', '''regDate_year''']
df = count_features(df, count_feature_list)
1.9 品牌和车型统计特征
这部分创建了丰富的统计特征,包括 brand (品牌) 和 model (车型) 下的车辆数量、价格的最大值、中位数、最小值、标准差和平均值。这些特征能够捕获品牌和车型对价格的影响。
# 新增特征: 品牌和车型统计特征
# 确定训练集的索引范围
train_num = sum(df['''SaleID'''].isin(Train_data['''SaleID''']))
train_part = df_copy.iloc[:train_num].copy()

# 品牌统计
train_gb = train_part.groupby("brand")
all_info = {}
for kind, kind_data in tqdm(train_gb, desc="品牌统计"):
    info = {}
    kind_data = kind_data[kind_data['''price'''] > 0]
    if len(kind_data) > 0:
        info['''brand_amount'''] = len(kind_data)
        info['''brand_price_max'''] = kind_data.price.max()
        info['''brand_price_median'''] = kind_data.price.median()
        info['''brand_price_min'''] = kind_data.price.min()
        info['''brand_price_std'''] = kind_data.price.std()
        info['''brand_price_average'''] = round(kind_data.price.sum() / (len(kind_data) + 1), 2)
        all_info[kind] = info
brand_fe = pd.DataFrame(all_info).T.reset_index().rename(columns={"index": "brand"})
df = df.merge(brand_fe, how='''left''', on='''brand''')

# 车型统计 (与品牌统计类似)
train_gb = train_part.groupby("model")
all_info = {}
for kind, kind_data in tqdm(train_gb, desc="车型统计"):
    info = {}
    kind_data = kind_data[kind_data['''price'''] > 0]
    if len(kind_data) > 0:
        info['''model_amount'''] = len(kind_data)
        info['''model_price_max'''] = kind_data.price.max()
        info['''model_price_median'''] = kind_data.price.median()
        info['''model_price_min'''] = kind_data.price.min()
        info['''model_price_std'''] = kind_data.price.std()
        info['''model_price_average'''] = round(kind_data.price.sum() / (len(kind_data) + 1), 2)
        all_info[kind] = info
model_fe = pd.DataFrame(all_info).T.reset_index().rename(columns={"index": "model"})
df = df.merge(model_fe, how='''left''', on='''model''')
1.10 类别特征统计聚合
对 kilometer, fuelType, bodyType 这三个类别特征,计算它们与 price 相关的各种统计量(计数、最大值、中位数、最小值、总和、标准差、平均值)。
# 新增特征: 5个类别特征的7种统计量计算
# 只对kilometer, fuelType, bodyType进行统计,brand和model已经在上面处理过了
cat_cols = ['''kilometer''', '''fuelType''', '''bodyType''']
for col in tqdm(cat_cols, desc="类别统计特征"):
    t = train_part.groupby(col, as_index=False)['''price'''].agg({
        col+'''_count''':'''count''',
        col+'''_price_max''':'''max''',
        col+'''_price_median''':'''median''',
        col+'''_price_min''':'''min''',
        col+'''_price_sum''':'''sum''',
        col+'''_price_std''':'''std''',
        col+'''_price_mean''':'''mean'''
    })
    df = pd.merge(df, t, on=col, how='''left''')

# kilometer与power的交叉统计
kk = ['''kilometer''', '''power''']
t1 = train_part.groupby(kk[0], as_index=False)[kk[1]].agg({
    kk[0]+'''_'''+kk[1]+'''_count''':'''count''',
    kk[0]+'''_'''+kk[1]+'''_max''':'''max''',
    kk[0]+'''_'''+kk[1]+'''_median''':'''median''',
    kk[0]+'''_'''+kk[1]+'''_min''':'''min''',
    kk[0]+'''_'''+kk[1]+'''_sum''':'''sum''',
    kk[0]+'''_'''+kk[1]+'''_std''':'''std''',
    kk[0]+'''_'''+kk[1]+'''_mean''':'''mean'''
})
df = pd.merge(df, t1, on=kk[0], how='''left''')
1.11 类别与数值交叉特征
创建类别特征 (model, brand, bodyType) 与数值特征 (power, kilometer, v_0, v_3, v_8, v_12) 的交叉统计特征,包括每组的最大值、最小值、平均值和标准差。
# 新增特征: 类别与数值交叉特征
def cross_cat_num(df, cat_col, num_col):
    for f1 in tqdm(cat_col, desc="交叉特征"):
        g = df.groupby(f1, as_index=False)
        for f2 in num_col:
            feat = g[f2].agg({
                f'{f1}_{f2}_max': '''max''',
                f'{f1}_{f2}_min': '''min''',
                f'{f1}_{f2}_mean': '''mean''',
                f'{f1}_{f2}_std': '''std'''
            })
            df = df.merge(feat, on=f1, how='''left''')
    return df

cross_cat = ['''model''', '''brand''', '''bodyType''']
cross_num = ['''power''', '''kilometer''', '''v_0''', '''v_3''', '''v_8''', '''v_12''']
df = cross_cat_num(df, cross_cat, cross_num)
1.12 更丰富的特征交互
创建了数值特征 (v_0, v_3, v_8, v_12) 之间的乘积、加法、减法特征,以及这些 v_ 特征与 car_age_year 的乘积特征,进一步丰富了模型的输入。
# 新增特征: 更丰富的特征交互方式
num_cols = [0, 3, 8, 12]  # 相关性较高的特征

for i in tqdm(num_cols, desc="    * 乘积特征"):
    for j in num_cols:
        df['''new'+str(i)+'''*'+str(j)] = df['''v_'+str(i)] * df['''v_'+str(j)]

for i in tqdm(num_cols, desc="    * 加法特征"):
    for j in num_cols:
        df['''new'+str(i)+'''+str(j)] = df['''v_'+str(i)] + df['''v_'+str(j)]

for i in tqdm(num_cols, desc="    * 减法特征"):
    for j in num_cols:
        df['''new'+str(i)+'''-'+str(j)] = df['''v_'+str(i)] - df['''v_'+str(j)]

for i in tqdm(range(15), desc="    * 车龄交互特征"):
    df['''new'+str(i)+'''*year'''] = df['''v_'+str(i)] * df['''car_age_year''']
1.13 特征归一化
使用 MinMaxScaler 对所有数值特征进行归一化处理,将它们缩放到 [0, 1] 的范围,这有助于神经网络的训练。
# 特征归一化
# 所有特征列(除了一些特殊列)
feature_cols = [col for col in df.columns if col not in ['''SaleID''', '''name''', '''regDate''', '''creatDate''', '''price''',
                                                        '''seller''', '''offerType''', '''train''', '''regDates''', '''creatDates''']]

print(f"    特征总数: {len(feature_cols)}")

# 将所有特征规范到相同尺度
scaler = MinMaxScaler()
scaler.fit(df[feature_cols].values)
df[feature_cols] = df[feature_cols].fillna(0)  # 保证特征无NaN

# 归一化
df_scaled = scaler.transform(df[feature_cols].values)
df_scaled = np.nan_to_num(df_scaled)  # 保证归一化后无NaN

# 切分数据
train_num = sum(df['''SaleID'''].isin(Train_data['''SaleID''']))
X_data = df_scaled[:train_num]
Y_data = np.array(df_copy['''price'''][:train_num])
Y_data = np.nan_to_num(Y_data)  # 保证标签无NaN
X_test = df_scaled[train_num:]
2. 神经网络模型 (Neural Network Model)
我构建了一个非常简单的全连接神经网络,虽然简单,但是效果还是不错的,训练速度也还可以,训练一轮大概10分钟以内,相比于复杂的残差网络,节省了不少训练时间。
2.1 NeuralNetwork 模型定义
这是一个五层的全连接神经网络,使用 ReLU 作为激活函数。
- 输入层:
input_dim(特征数量) - 隐藏层: 512 -> 256 -> 128 -> 64
- 输出层: 1 (用于回归预测价格)
模型中还包含了L2正则化 (self.l2_reg) 以防止过拟合,并且使用了凯明初始化(He初始化)来初始化权重,将偏置初始化为0。
# 定义PyTorch神经网络模型
class NeuralNetwork(nn.Module):
    def __init__(self, input_dim):
        super(NeuralNetwork, self).__init__()
        self.fc1 = nn.Linear(input_dim, 512)
        self.fc2 = nn.Linear(512, 256)
        self.fc3 = nn.Linear(256, 128)
        self.fc4 = nn.Linear(128, 64)
        self.fc5 = nn.Linear(64, 1)
        self.relu = nn.ReLU()

        # 添加L2正则化
        self.l2_reg = 0.05  # 增大正则化参数以适应更高维度的特征

        # 应用凯明初始化(He初始化)
        nn.init.kaiming_normal_(self.fc1.weight, nonlinearity='''relu''')
        nn.init.kaiming_normal_(self.fc2.weight, nonlinearity='''relu''')
        nn.init.kaiming_normal_(self.fc3.weight, nonlinearity='''relu''')
        nn.init.kaiming_normal_(self.fc4.weight, nonlinearity='''relu''')
        nn.init.kaiming_normal_(self.fc5.weight, nonlinearity='''relu''')

        # 初始化偏置为0
        nn.init.zeros_(self.fc1.bias)
        nn.init.zeros_(self.fc2.bias)
        nn.init.zeros_(self.fc3.bias)
        nn.init.zeros_(self.fc4.bias)
        nn.init.zeros_(self.fc5.bias)

    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        x = self.relu(self.fc3(x))
        x = self.relu(self.fc4(x))
        x = self.fc5(x)
        return x

    def get_l2_loss(self):
        l2_loss = 0.0
        for param in self.parameters():
            l2_loss += torch.norm(param, 2)
        return self.l2_reg * l2_loss
2.2 LRScheduler 学习率调度器
该调度器在特定训练轮次(200, 300, 360, 420)降低学习率,这有助于模型在训练后期更好地收敛。
# 学习率调度器
class LRScheduler:
    def __init__(self, optimizer):
        self.optimizer = optimizer

    def step(self, epoch):
        lr = self.optimizer.param_groups[0]['''lr''']
        if epoch == 200:
            lr *= 0.5
        elif epoch == 300:
            lr *= 0.2
        elif epoch == 360:
            lr *= 0.1
        elif epoch == 420:
            lr *= 0.1

        for param_group in self.optimizer.param_groups:
            param_group['''lr'''] = lr

        return lr
2.3 EarlyStopping 早停机制
早停机制用于监控验证损失,如果在设定的 patience (耐心) 轮次内验证损失没有改善,则停止训练,并加载性能最佳的模型。这可以防止模型过拟合训练数据。
# 早停机制
class EarlyStopping:
    def __init__(self, patience=100, verbose=True):
        self.patience = patience
        self.verbose = verbose
        self.counter = 0
        self.best_score = None
        self.early_stop = False
        self.val_loss_min = float('''inf''')
        self.best_model_state = None

    def __call__(self, val_loss, model):
        score = -val_loss # 通常用于最大化某个指标,这里是最小化损失所以取负

        if self.best_score is None:
            self.best_score = score
            self.save_checkpoint(val_loss, model)
        elif score < self.best_score:
            self.counter += 1
            if self.verbose:
                print(f'''EarlyStopping counter: {self.counter} out of {self.patience}''')
            if self.counter >= self.patience:
                self.early_stop = True
        else:
            self.best_score = score
            self.save_checkpoint(val_loss, model)
            self.counter = 0

    def save_checkpoint(self, val_loss, model):
        if self.verbose:
            print(f'''验证损失减少 ({self.val_loss_min:.6f} --> {val_loss:.6f}). 保存模型...''')
        self.best_model_state = model.state_dict().copy()
        self.val_loss_min = val_loss

    def load_best_model(self, model):
        model.load_state_dict(self.best_model_state)
        return model
2.4 训练与验证函数
train_epoch: 执行一个训练轮次。模型设置为训练模式 (model.train()),计算L1损失 (nn.L1Loss()) 并加上L2正则化损失。使用Adam优化器更新模型参数。validate_epoch: 执行一个验证轮次。模型设置为评估模式 (model.eval()),计算验证损失,并收集预测结果。
# 训练一个epoch
def train_epoch(model, train_loader, optimizer, scheduler, epoch, progress_callback):
    model.train()
    total_loss = 0
    progress_callback.on_epoch_begin(epoch)

    for i, (inputs, targets) in enumerate(train_loader):
        inputs, targets = inputs.to(device), targets.to(device)

        optimizer.zero_grad()
        outputs = model(inputs)
        loss = nn.L1Loss()(outputs, targets.view(-1, 1))
        reg_loss = model.get_l2_loss()
        total_loss = loss + reg_loss

        total_loss.backward()
        optimizer.step()

        batch_logs = {'''loss''': total_loss.item()}
        progress_callback.on_batch_end(i, batch_logs)

    return total_loss.item() / len(train_loader)

# 验证一个epoch
def validate_epoch(model, val_loader):
    model.eval()
    val_loss = 0
    predictions = []
    targets_list = []

    with torch.no_grad():
        for inputs, targets in val_loader:
            inputs, targets = inputs.to(device), targets.to(device)
            outputs = model(inputs)
            val_loss += nn.L1Loss()(outputs, targets.view(-1, 1)).item()

            predictions.extend(outputs.cpu().numpy().flatten())
            targets_list.extend(targets.cpu().numpy())

    val_loss /= len(val_loader)
    return val_loss, predictions, targets_list
2.5 K折交叉验证
使用了10折交叉验证 (KFold) 来训练模型。
- 在每次折叠中,数据被划分为训练集和验证集。
- 模型在训练集上进行训练,并在验证集上评估性能(使用MAE,Mean Absolute Error)。
- 早停机制和学习率调度器在每个折叠的训练过程中独立应用。
- 测试集的预测结果是所有折叠预测结果的平均值,这有助于提高模型的泛化能力并减少过拟合。
- MAE是评估回归模型常用的指标,表示预测值和真实值之间平均绝对误差。
# K折交叉验证训练
# 设置交叉验证参数
n_splits = 10  # KFold要求至少为2
skf = KFold(n_splits=n_splits, shuffle=True)
oof = np.zeros(len(X_data)) # Out-of-fold 预测
predictions = np.zeros(len(X_test))  # 初始化预测结果数组
mae = 0
fold_scores = []

# 设置要运行的折数
total_folds = n_splits

print(f"将进行{total_folds}次训练验证...")

# 获取所有折的索引
all_folds = list(skf.split(X_data, Y_data))
# 只执行指定次数的循环
for i in range(total_folds):
    # ... (训练和验证循环,早停,预测测试集和验证集) ...

    # 预测测试集
    model.eval()
    test_tensor = torch.FloatTensor(X_test).to(device)
    test_dataset = TensorDataset(test_tensor, torch.zeros(len(X_test)))
    test_loader = DataLoader(test_dataset, batch_size=batch_size_cv)

    test_preds = []
    with torch.no_grad():
        for inputs, _ in test_loader:
            inputs = inputs.to(device)
            outputs = model(inputs)
            test_preds.extend(outputs.cpu().numpy().flatten())

    predictions += np.array(test_preds) / skf.n_splits # 对所有折的预测进行平均

    # 预测验证集 (用于计算oof和当前折的MAE)
    val_preds_final = []
    with torch.no_grad():
        for inputs, _ in DataLoader(TensorDataset(val_x_tensor, torch.zeros(len(val_x))), batch_size=batch_size_cv):
            inputs = inputs.to(device)
            outputs = model(inputs)
            val_preds_final.extend(outputs.cpu().numpy().flatten())

    oof[val_idx] = np.array(val_preds_final)
    fold_mae = mean_absolute_error(val_y, oof[val_idx])
    fold_scores.append(fold_mae)
    mae += fold_mae / skf.n_splits
    fold_time = time.time() - fold_start_time
    print(f"第 {i+1} 折 MAE: {fold_mae:.4f}")
    print(f"第 {i+1} 折耗时: {fold_time:.2f}秒")

print(f"\n交叉验证完成! 各折MAE: {[f'{score:.4f}' for score in fold_scores]}")
print(f"平均 MAE: {mae:.4f}")
2.6 结果保存
最后,代码将训练集上的oof预测和测试集上的平均预测结果保存为CSV文件,以便后续可能进行模型融合。同时,也保存了最终的测试集预测结果文件。
# 生成提交文件
# 保存用于模型融合的训练集和测试集预测结果
train_results = pd.DataFrame()
train_results['''SaleID'''] = Train_SaleID
train_results['''price'''] = oof  # 神经网络直接在原始空间训练,无需转换
train_results.to_csv(user_data_path + '''nn_train.csv''', index=False)

test_results = pd.DataFrame()
test_results['''SaleID'''] = Test_SaleID
test_results['''price'''] = predictions  # 神经网络直接在原始空间预测,无需转换
test_results.to_csv(user_data_path + '''nn_test.csv''', index=False)

# 保存最终预测结果
sub = pd.DataFrame()
sub['''SaleID'''] = Test_SaleID
sub['''price'''] = predictions
sub.to_csv(output_path + '''predictions_nn.csv''', index=False)
print(f"预测结果已保存到: {output_path}predictions_nn.csv")
print(f"模型融合所需文件已保存到: {user_data_path}")
结语
尽管我付出了大量努力,但最终未能登顶。第一名的分数高达391,我猜测他可能进行了非常特别的特征工程。我还是挺期待着第一名的心得分享,希望能从中学习到更多特征的处理方式。也欢迎大家向我提问,一起学习,一起进步